近年来,英伟达始终在技术领域处于领先位置,接连推出了众多具有革新意义的技术功能,其中表现最为亮眼的便是人工智能图像增强技术DLSS,而在最近举办的GTC 2026大会上,这家公司再次发布了一项突破性的技术成果——神经纹理压缩。
这项人工智能技术据介绍能够在运行游戏时将显存的占用量降低85%,同时确保画质不会出现任何损失。其神经纹理压缩的演示画面显示,在显存占用从6.5GB减少到970MB的过程中,实现了令人惊叹的视觉效果一致性。
随着游戏的复杂程度和逼真程度不断提升,游戏行业对图像放大技术的依赖程度也日益增加,以此来满足不断增长的硬件性能需求。这种优化方面的不足导致了一个主要问题,那就是显存占用率在近年来出现了急剧上升的情况。为了有效解决这一问题,英伟达研发出了名为“神经纹理压缩”NTC的技术,并在今日的GTC大会上再次对其进行了介绍。性能最为强大的显卡将能够充分发挥英伟达NTC技术的优势。
NTC技术允许开发者运用小型神经网络对任何场景中的纹理进行解包处理。这一过程不仅能够显著缩小纹理的体积,让游戏的安装过程更加简便,还能在运行时降低显存的占用量。另外,最终生成的纹理质量也得到了提升,英伟达表示最终渲染的分辨率最高能够实现4倍的提升。
在下面的示例展示中,英伟达运行了一个托斯卡纳别墅的场景,当使用标准块BCN压缩方式时,显存占用达到6.5GB,而切换到NTC技术后,显存占用量降至仅970MB,并且图像效果与之前完全一致。
在此之前,该公司的另一个演示呈现了一个飞行头盔,其未经过压缩的纹理占用272MB——采用块压缩后将其减少到98MB,而使用NTC技术则进一步将其减少到仅11.37MB,大约是原始纹理占用量的二十四分之一。
目前还不确定这项技术是否会推广应用到旧款显卡上,但像RTX 5060或5060Ti这类配备8GB显存的显卡用户应该会从中获得实际的好处。DLSS 5一直以来存在不少争议,但这项新技术应该会受到许多用户的喜爱和欢迎。
英伟达还展示了神经材质Neural Materials,其设计理念与此相同:借助神经网络对材质纹理数据进行评估和解压缩处理,而不是依靠计算量庞大的双向反射分布函数BRDF数学运算。
通常情况下,一种材质会堆叠多个纹理贴图,GPU必须在渲染管线中同时计算光线与每一层纹理之间的交互方式。神经材质技术只需要向神经网络询问光线在特定场景下的反应情况,并根据得到的结果来调整像素的着色效果。神经网络会基于所有的纹理数据进行训练,所以它已经知道在给定光线和角度条件下的结果。正因为如此,在演示场景中,英伟达在1080p分辨率下实现了高达7.7倍的渲染速度提升,并且图像质量丝毫没有降低。
NTC技术之所以具有如此高的效率,是因为它运用了矩阵加速引擎。在现代GPU中,矩阵加速引擎是一个独立的硬件模块,因此不会对基础性能产生影响。英伟达将其称为Tensor Core,英特尔称之为XMX引擎,AMD则称之为AI加速器。DLSS、FSR和XeSS等图像放大技术同样依赖于这一模块,它们能够将低分辨率的帧重建为更高分辨率的输出画面,所以这也是英伟达神经渲染计划中的一部分。
神经渲染的概念目前在业界还没有得到广泛的认可,“神经网络”这个词汇可能会让你觉得这只是另一种人工智能的不成熟尝试。但实际情况恰恰相反,它可以称得上是人工智能的优秀应用之一,因为它完全不涉及生成过程。NTC技术只会针对游戏开发过程中需要参考的特定纹理集进行训练,所以不会出现任何虚构的内容。
纹理是所有游戏中占用显存最多的组件,所以任何能够对纹理占用进行控制的技术都值得受到欢迎。不过需要注意的是,这项技术并非英伟达所独有,微软已经将其标准化为DirectX中的“协作向量”Cooperative Vectors。英特尔此前也展示过其纹理演示,与块压缩相比,纹理效果有着明显的优势。AMD上次提及这项技术是在2024年,但该公司很可能也在积极开展相关的研究工作。
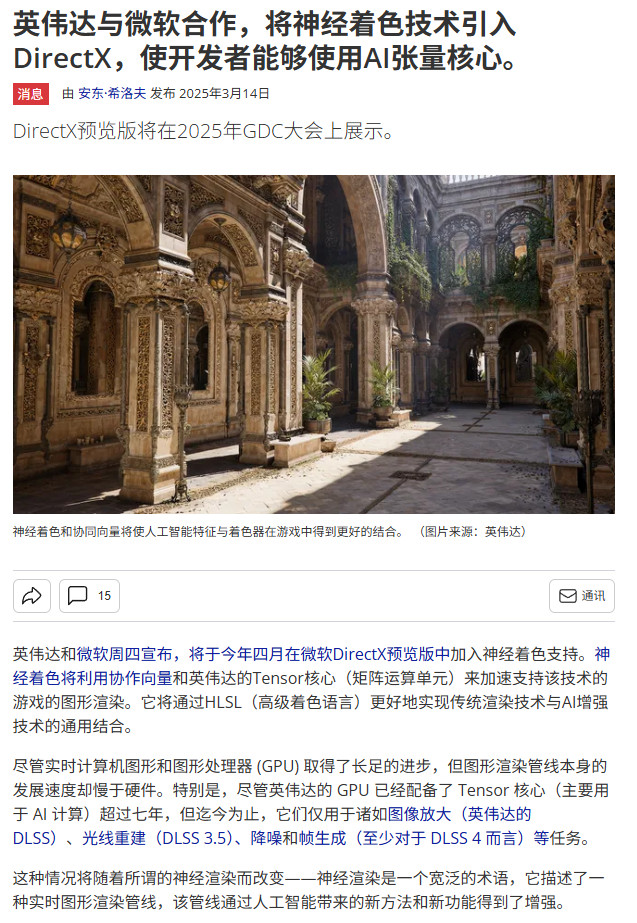
目前,还没有游戏支持合作向量或英伟达的神经纹理压缩技术,但考虑到行业的发展趋势,我们应该很快就能看到它们在实际游戏中的应用。人工智能似乎已经成为解决所有传统问题的有效方法,各大公司也在不断探索将其应用于各种看似不相关的领域。然而,像神经纹理压缩这样的创新成果表明,人工智能可以巧妙地应用到实际场景中,从而产生真正有价值的影响。